9 skills de DevOps que necesitas saber sí o sí en 2026
Contenedores, orquestación, infraestructura como código, observabilidad y la factura de la nube. Lo que hay entre tu código y que funcione para alguien.
1. Contenedores
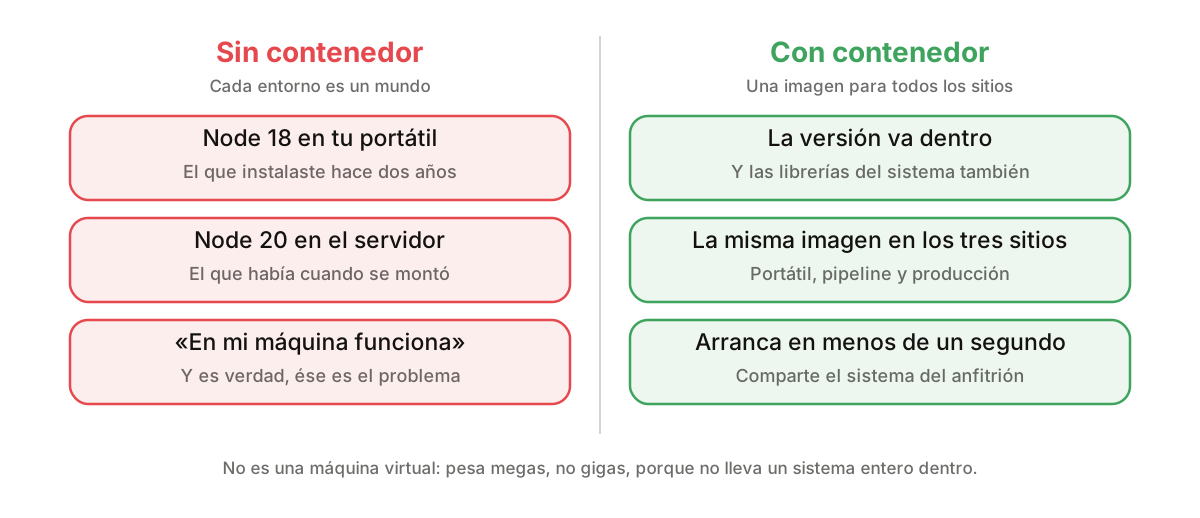
Un contenedor empaqueta tu aplicación con todo lo que necesita para arrancar: la versión exacta del lenguaje, las librerías del sistema, la configuración. Se ejecuta igual en tu portátil, en el pipeline y en producción, porque literalmente es lo mismo.
No es una máquina virtual: no lleva un sistema operativo entero dentro, comparte el del anfitrión. Por eso arranca en menos de un segundo y pesa megas en vez de gigas. Y por eso el famoso «en mi máquina funciona» dejó de ser una excusa: tu máquina y la de producción son la misma imagen.
2. Orquestación: Kubernetes
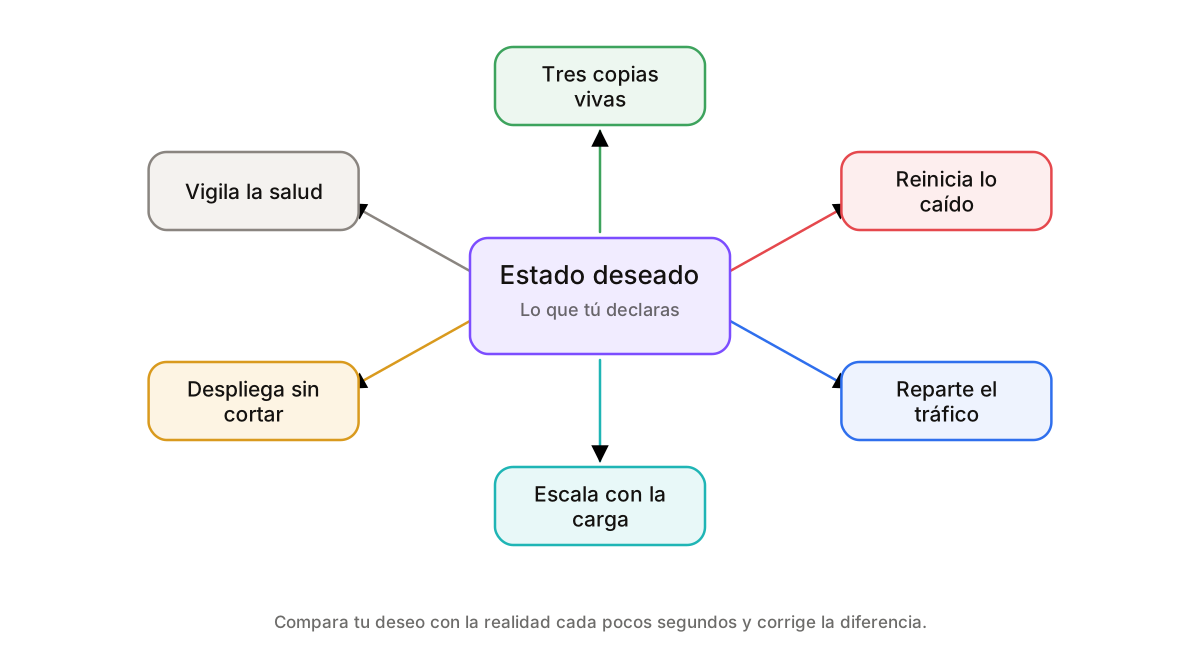
Con un contenedor no necesitas Kubernetes. Con cuarenta, repartidos en varias máquinas, que tienen que encontrarse entre ellos, escalar cuando llega gente y levantarse solos cuando se caen, sí necesitas algo. Eso es un orquestador.
Lo importante es entender el cambio de mentalidad: tú no le das órdenes, le declaras el estado que quieres. «Quiero tres copias de esto, con esta memoria, alcanzables en esta dirección». Él compara ese deseo con la realidad cada pocos segundos y hace lo que haga falta para que coincidan. Se cae una máquina y levanta otra sin que nadie llame a nadie.
3. Infraestructura como código
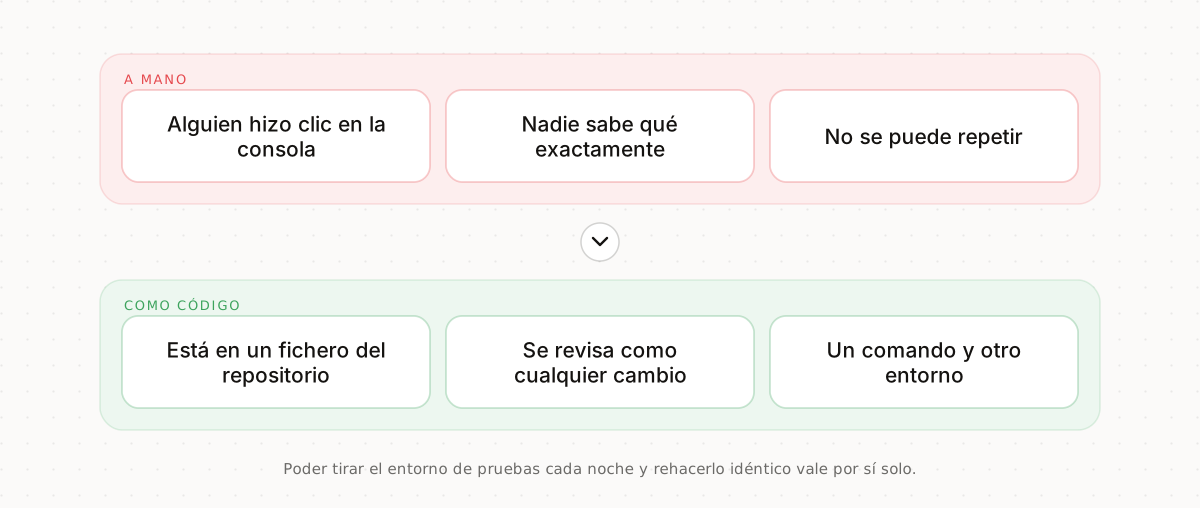
Montar la infraestructura a mano en la consola de tu proveedor tiene dos problemas: nadie sabe qué se hizo exactamente y nadie puede repetirlo. Seis meses después hay veinte recursos que nadie se atreve a tocar porque nadie recuerda para qué son.
Con infraestructura como código, todo eso vive en ficheros que están en tu repositorio: se revisan como cualquier cambio, se sabe quién tocó qué y montar un entorno nuevo es ejecutar un comando. Y lo que más se agradece es lo aburrido: puedes tirar el entorno de pruebas entero cada noche y volver a levantarlo idéntico por la mañana.
4. El pipeline
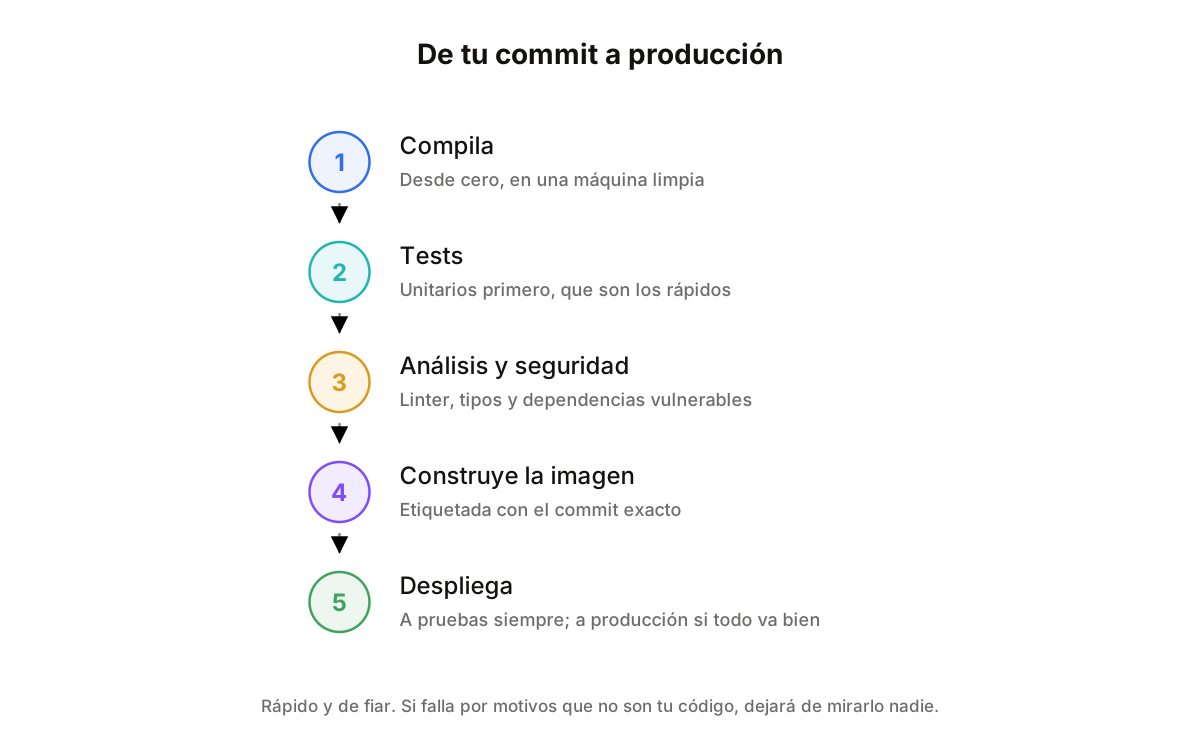
El pipeline es la cinta transportadora entre tu commit y producción: compilar, pasar los tests, analizar el código, construir la imagen, desplegar. Cada paso solo se ejecuta si el anterior fue bien, y cualquiera del equipo puede ver en qué punto se paró y por qué.
Dos reglas que marcan la diferencia. Rápido, porque un pipeline de cuarenta minutos hace que la gente agrupe cambios y agrupar cambios es exactamente lo que no queremos. Y de fiar: si falla por motivos que no son el código, en dos semanas nadie mirará por qué está rojo.
5. Observabilidad: métricas, logs y trazas
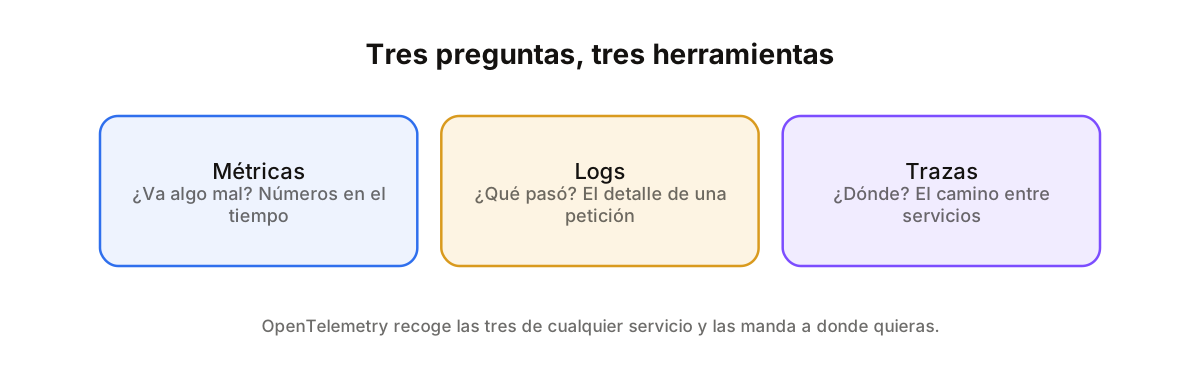
Cuando algo falla en producción necesitas responder a tres preguntas y cada una tiene su herramienta. Las métricas dicen que algo va mal: los errores han subido, la latencia se ha disparado. Los logs dicen qué pasó exactamente en una petición concreta. Y las trazas dicen dónde: por qué servicios pasó y cuánto tardó en cada uno.
Con métricas solas sabes que arde algo pero no qué. Con logs solos tienes millones de líneas y ninguna forma de relacionarlas. OpenTelemetry es el estándar para recoger las tres de cualquier servicio y mandarlas a donde quieras: lo instrumentas una vez y dejas de adivinar.
6. Configuración y secretos
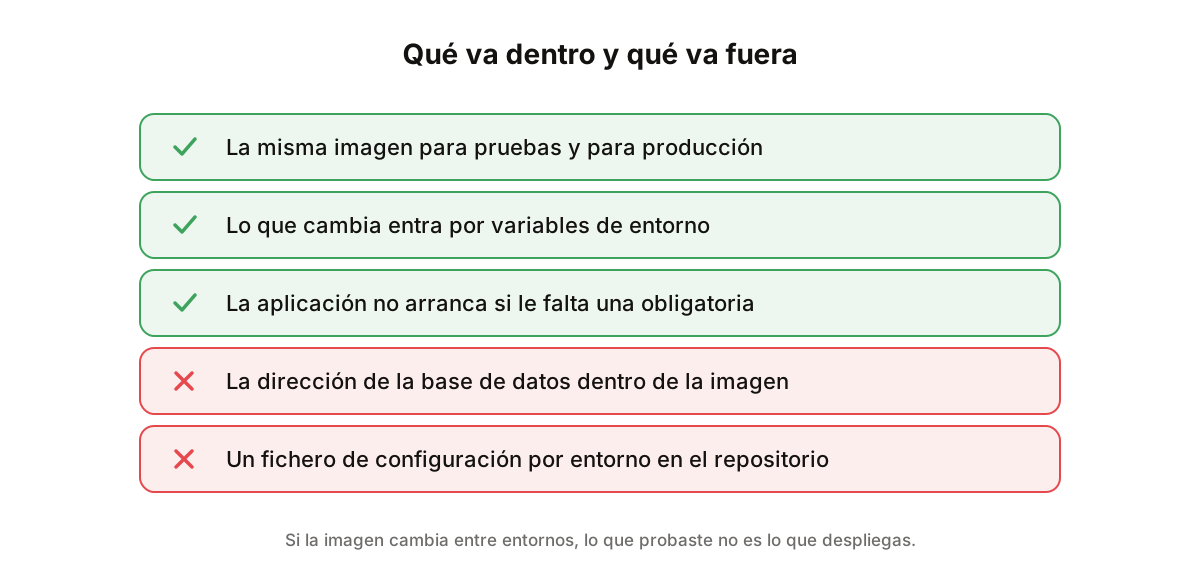
La misma imagen tiene que servir para pruebas y para producción. Si dentro lleva la dirección de la base de datos, no es la misma imagen: es otra, y lo que has probado no es lo que vas a desplegar.
Todo lo que cambia entre entornos entra por fuera, en variables de entorno o en un gestor de configuración. Y los secretos, aparte: en un gestor que los rote, con un permiso por servicio y sin pasar jamás por el repositorio. Que la aplicación se niegue a arrancar si le falta uno es mejor que descubrirlo con la primera petición.
7. Escalar: hacia arriba y hacia los lados
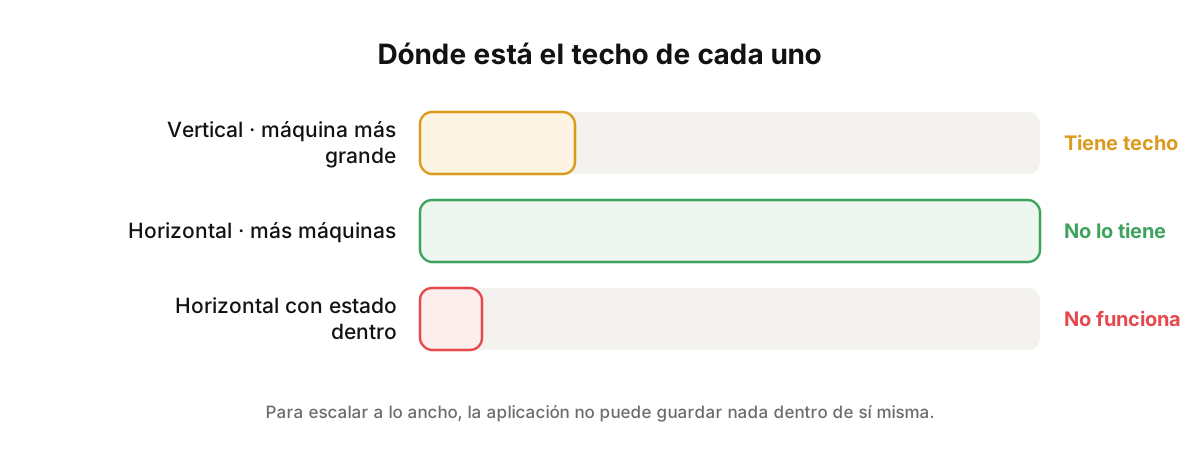
Escalar en vertical es poner una máquina más grande. Es lo más fácil, funciona hasta un punto y tiene dos problemas: llega un momento en que no hay máquina más grande, y mientras tanto sigues teniendo una sola cosa que se puede caer.
Escalar en horizontal es poner más máquinas iguales y repartir el tráfico. No tiene techo y aguanta caídas, pero te obliga a una cosa: que tu aplicación no guarde nada dentro. Ni sesiones en memoria ni ficheros en disco local, porque la siguiente petición irá a otra máquina que no sabe nada de eso.
8. Desplegar sin cortar el servicio
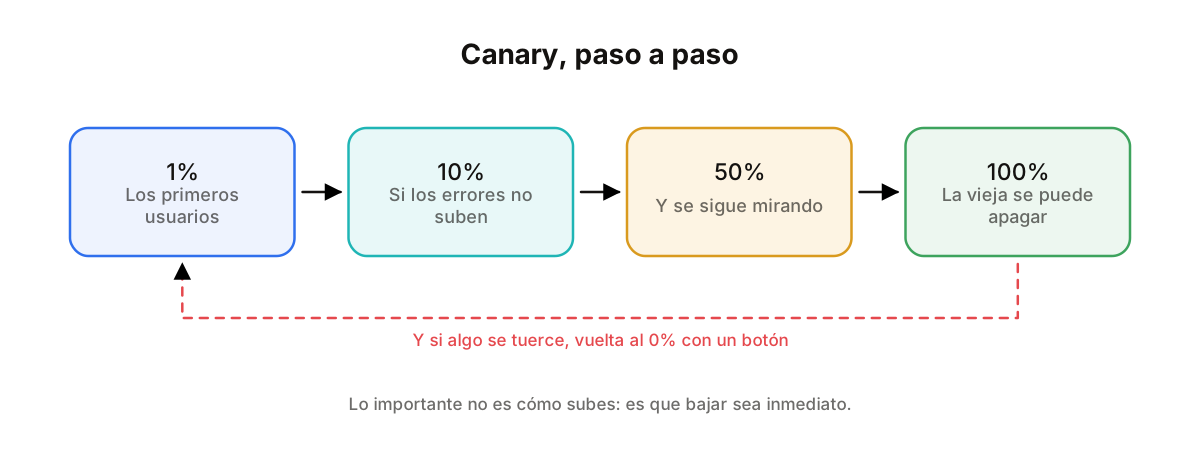
Desplegar apagando lo viejo y encendiendo lo nuevo significa un rato sin servicio y, si sale mal, un rato largo. Hay dos formas de evitarlo y las dos se basan en lo mismo: que la versión nueva conviva con la vieja un rato.
En blue-green levantas la nueva entera al lado, compruebas que va y cambias el tráfico de golpe; volver atrás es cambiarlo otra vez. En canary le mandas primero al 1% de los usuarios, miras los errores y vas subiendo. Y lo importante de las dos es lo mismo: que volver atrás sea un botón y no una noche.
9. Lo que cuesta tu nube
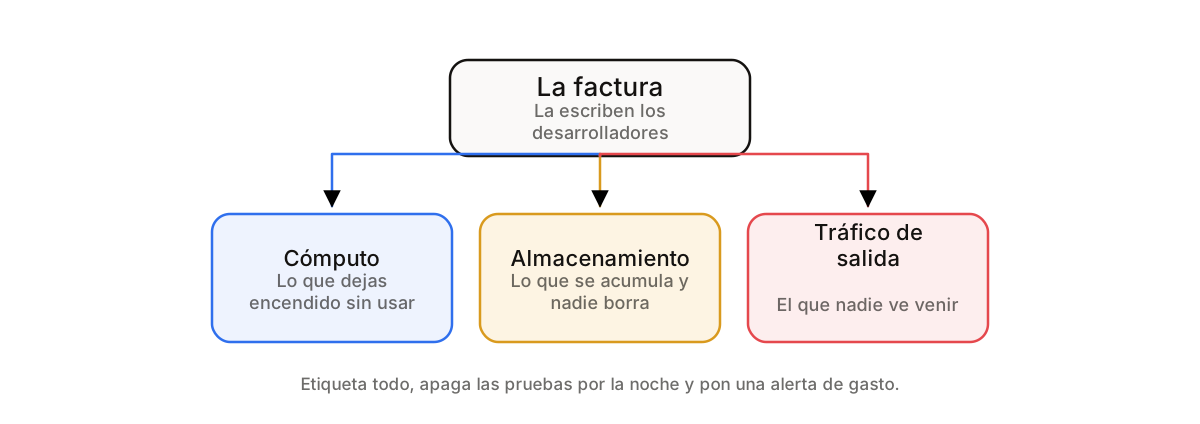
La factura de la nube tiene una particularidad: la escriben los desarrolladores y la lee el director financiero. Y casi siempre se reparte igual entre tres cosas: el cómputo que tienes encendido, el almacenamiento que se acumula y el tráfico de salida.
El tercero es el que sorprende. Sacar datos de la nube se paga, y entre regiones también, así que mover ficheros de un sitio a otro sin pensarlo cuesta más que tenerlos. Tres costumbres bastan para la mayoría: etiquetar todo para saber de quién es cada cosa, apagar los entornos de prueba por la noche, y poner una alerta cuando el gasto se salga de lo normal.
Resumen
- El contenedor es la misma imagen en los tres sitios.
- Al orquestador se le declara el estado, no se le dan órdenes.
- La infraestructura vive en el repositorio, no en la consola.
- El pipeline: rápido y de fiar, o dejará de mirarlo nadie.
- Métricas para saber que arde, trazas para saber dónde.
- Lo que cambia entre entornos entra por fuera.
- Para escalar a lo ancho, nada de estado dentro.
- Canary o blue-green: que volver atrás sea un botón.
- Cómputo, almacenamiento y tráfico de salida. El tercero sorprende.
DevOps no es un puesto de trabajo, es todo lo que hay entre tu código y que le funcione a alguien. No hace falta que lo montes tú, pero sí saber qué pasa ahí: la mayoría de las noches malas de un equipo no vienen de un fallo en el código, vienen de un despliegue que nadie sabía deshacer.